万亿美元订单背后,一场静悄悄的革命正在改变我们每个人
作者: owner | 发布时间: 2026-03-17
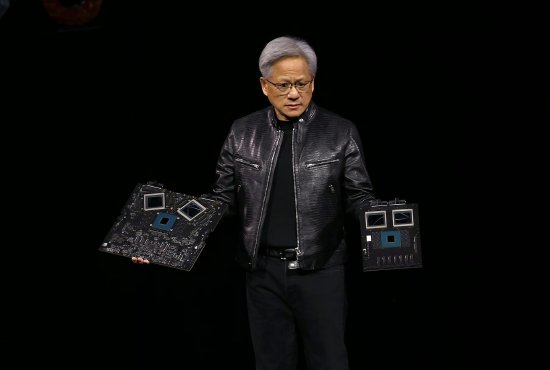
老张是个普通的北京上班族,每天早上挤地铁的时候,他习惯性地掏出手机,点开ChatGPT问一句"今天有啥科技新闻"。几秒钟后,一段文字蹦了出来。老张不会想到,就在他滑动屏幕的这几秒里,背后是一颗指甲盖大小的芯片在进行着数万亿次的运算——而就在昨天,这颗芯片刚刚完成了自我进化,算力提升了整整5倍。 2026年3月16日,圣何塞SAP中心,英伟达创始人黄仁勋站在GTC 2026年度大会的舞台上,宣布了一个足以改变人工智能产业走向的重磅消息——Vera Rubin AI加速平台正式发布。 5倍算力提升,1万亿美元订单承诺,一个以天文学家命名的芯片——这些数字和技术术语看起来离普通人的生活很远。但当你读完这篇文章,你会发现:这场静悄悄的革命,其实正在偷偷改变我们每个人的未来。 壹 3360亿个晶体管——这是Vera Rubin芯片里的数字。 如果把单个晶体管比作一粒沙子,那么一颗Rubin GPU中的晶体管数量,相当于地球上所有海滩沙粒的总和数百倍。这些微小的开关在黄仁勋的指挥下,以每秒数千万亿次的频率进行着复杂的数学运算,支撑起整个人工智能时代的算力基础设施。 台积电3纳米制程是这一技术突破的物理基础。纳米制程指的是晶体管的栅极长度,数值越小意味着在同等面积上可以集成更多的晶体管,同时降低功耗。3纳米制程相较于上一代Blackwell的制程工艺,在晶体管密度上提升了超过60%,这直接转化为更强的计算能力和更高的能效比。 但真正令业界震惊的是Rubin在能效比上的突破。黄仁勋在主题演讲中强调,Vera Rubin平台在推断token成本上较Blackwell降低10倍,训练混合专家(MoE)模型所需GPU数量减少75%。与Grace Blackwell相比,Vera Rubin每瓦特可交付的性能提升10倍。 这是什么意思?意味着同等算力下的电力成本大幅下降,意味着AI应用的运营成本大幅降低,最终——这些成本节约将传导至终端用户。 贰 50 PFLOPS的推断算力究竟是什么概念? PFLOPS,即每秒千万亿次浮点运算,是衡量超级计算机性能的通用单位。以当前最先进的个人电脑GPU为例,其算力通常在几十TFLOPS(万亿次浮点运算)级别,而Rubin的50 PFLOPS相当于50000 TFLOPS。这意味着Rubin单个GPU的算力,超过数千台高端个人电脑的算力总和。 英伟达在发布会上展示了一个更具冲击力的对比:整个Vera Rubin NVL72机架配备260 TB/秒的NVLink 6带宽——据英伟达称,这已超过整个互联网的带宽总量。 当你在家中观看4K视频、下载文件、进行视频通话时,你所使用的数据传输带宽相加,也远远不及这个机架的内部带宽。 这种算力级别的提升,绝不仅仅是数字上的进步,而是质的飞跃。它意味着以前只能在超级计算机上运行的AI模型,现在可以被部署到更广泛的应用场景中;意味着以前需要等待数小时的AI推理任务,现在可以在几秒钟内完成;意味着以前只存在于科幻电影中的人工智能应用,正在加速走进现实。 叁 对于老张这样的普通用户而言,5倍算力提升究竟意味着什么? 最直接的感知将是AI应用响应速度的质变。以对话式AI为例,当你与ChatGPT、Claude或其他AI助手进行对话时,AI需要在你输入文字后进行复杂的推理运算,生成回复。以目前的技术条件,大型语言模型的推理通常需要数秒到数十秒不等。Rubin芯片将这一时间大幅缩短。在5倍算力提升的加持下,同样的模型可以在更短的时间内完成推理,用户将体验到接近实时的对话响应。这意味着AI助手将变得更加流畅自然,对话中的停顿和等待将大大减少。 AI绘画、AI视频生成、AI音乐创作等创意工具将受益匪浅。以AI绘画为例,当前生成一张高质量图像可能需要数十秒到数分钟。使用Rubin芯片后,这一时间可能缩短到几秒钟。这意味着创意工作者可以更快地迭代创意,普通用户也可以更便捷地使用AI生成自己需要的内容。 基于AI的实时翻译将变得更加准确和流畅。在5倍算力的支持下,翻译模型可以运行更大的模型规模,使用更复杂的注意力机制,从而提供更准确的翻译结果。跨国商务会议、在线教育、国际交流等场景将因此受益。 肆 算力提升不仅意味着速度加快,更意味着质量的提升。