黄仁勋又扔出一颗“王炸”:算力暴涨5倍,但最可怕的不是数字
作者: owner | 发布时间: 2026-03-17
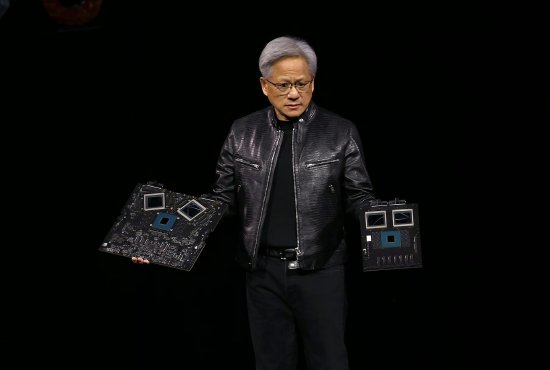
2026年3月16日,圣何塞SAP中心。 黄仁勋走上GTC 2026舞台的时候,台下坐着来自全球的近两万名开发者、工程师和投资人。这位出生于台湾的英伟达创始人今年已经62岁,但依然穿着他那件标志性的黑色皮夹克,讲话时喜欢用手势比划,语速快得让同声传译员都跟不上。 他没有废话,直接掏出了新一代AI芯片——Vera Rubin。 那一刻,全世界做AI的公司都该认真想一想:接下来该怎么办? 壹 先说最直观的数据。 Rubin芯片采用了台积电3纳米制程,集成了3360亿颗晶体管。这个数字是什么概念?比上一代Blackwell的2080亿多了整整60%。一颗芯片里埋了3360亿个晶体管,相当于把全世界的人口(80亿)乘以42倍,再全部塞进一个只有手掌大小的硅片里。 但真正让全场倒吸一口凉气的,是算力数字。 Rubin的推断算力达到了50 PFLOPS(FP4精度),是Blackwell的5倍。训练算力35 PFLOPS,是Blackwell的3.5倍。 5倍。 这不是挤牙膏式的进步,这是直接把牙膏管给捏爆了。 贰 但我今天不想跟你聊那些枯燥的技术指标。我想问你一个更实际的问题: 算力提升5倍,对普通用户意味着什么? 让我给你算一笔账。 如果你用AI生成一段60秒的视频,以前需要等10分钟,以后可能只需要2分钟。如果你让AI帮你写一份市场分析报告,以前需要30秒,以后可能只需要6秒。如果你问AI一个问题,以前它要思考3秒才能回答,以后可能只需要0.6秒。 当然,这只是理论计算。但关键是,这种提升不是线性的,而是叠加的。当算力提升5倍,成本下降10倍的时候,整个AI应用的生态都会被重构。 黄仁勋在演讲中扔出了一个更吓人的数字:Rubin平台在推断token成本上较Blackwell降低10倍,训练混合专家(MoE)模型所需GPU数量减少75%。 10倍。 这意味着什么?意味着以前只有大公司才玩得起的AI应用,以后小公司甚至个人开发者都能做了。意味着你手机上的AI助手可能会变得更聪明,响应速度会更快,甚至可以本地运行一些以前只能在云端运行的模型。